반응형
■ 코스피에 등록된 종목 리스트 필터링 하기
종목은 어떻게 고르나? #2 - 10% 상승 후보 순위
■10% 상승 가능한 종목 후보들의 순위코스피 전체 종목 → 기본 필터 → 수급 → 기술적 분석 → 매물대 → 상대강도 → 종합점수 → TOP 종목 순서로 파이썬 프로그램을 만들어 봅니다. 핵심 조
tool-2020.tistory.com
"stock_list_collector.py" 파일로 "kospi_price.db" 파일을 만들고, 코스피 주식 종목 모두를 저장 하는 "kospi_stock_info" 테이블을 만들었습니다, 테이블 항목은 "종목코드 , 종목명, 시가총액, 상장주식수,날짜" 입니다. 대략 900여개의 종목들이 있습니다.
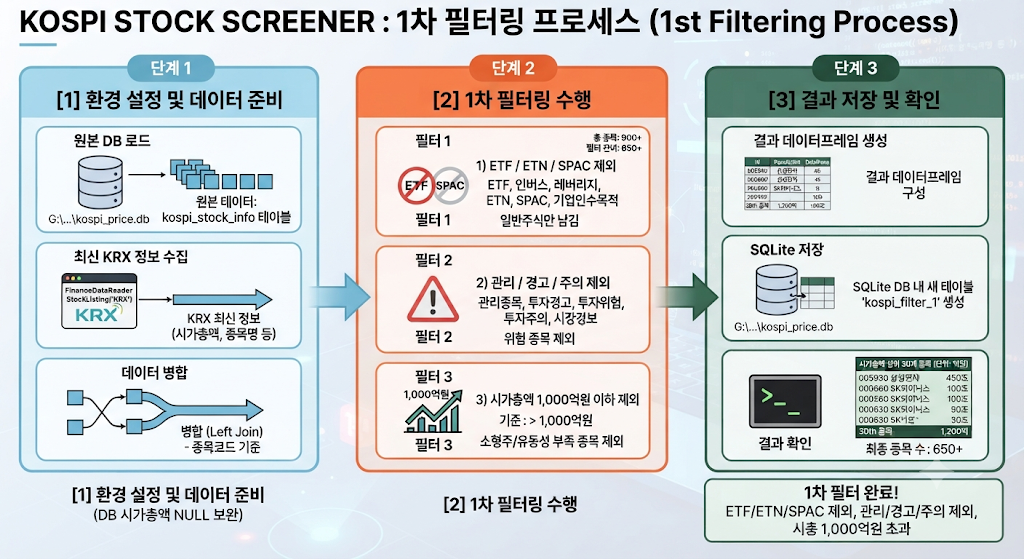
아래와 같은 조건으로 1차 필터링을 하고, 별도의 테이블에 저장 합니다. 테이블 이름은 "kospi_filter_1" 입니다.
- ETF/ETN/SPAC 제외
- 관리/경고/주의는 제외
- 시총 1,000억 이하 제외
■ 주식 스크리너(Stock Screener) 프로그램
SQLite 데이터베이스에 저장된 KOSPI 주식 데이터를 불러와, 몇 가지 조건(ETF/ETN/SPAC 제외, 관리/경고/주의 종목 제외, 시가총액 1,000억원 초과)에 따라 1차 필터링을 수행하는 주식 스크리너(Stock Screener) 프로그램입니다.
⚙️ 주요 기능 및 단계별 설명
1. 환경 설정 및 데이터 준비 (check_database & get_krx_data)
- 원본 DB 로드: 지정된 경로(G:\00PythonProjects\kospi_stock_screener\data\kospi_price.db)의 SQLite DB에서 kospi_stock_info 테이블을 읽어옵니다.
- 최신 KRX 정보 수집: FinanceDataReader 라이브러리의 StockListing("KRX")를 이용해 최신 한국거래소(KRX) 상장 종목 목록과 시가총액(Marcap) 등의 데이터를 가져온 뒤 KOSPI 종목만 필터링합니다.
- 데이터 병합: 원본 DB의 종목 데이터에 최신 KRX의 시가총액과 상장주식수 데이터를 종목코드 기준으로 안전하게 결합(left join)합니다. (DB의 시가총액이 누락된 경우를 보완하기 위함입니다.)
2. 1차 필터링 수행
세 가지 핵심 기준으로 스크리닝을 진행합니다.
- 필터 1: ETF / ETN / SPAC 제외 (filter_etf_etn_spac)
종목명에 'ETF', '인버스', '레버리지', 'ETN', 'SPAC', '기업인수목적' 등의 키워드가 포함된 파생상품 및 특수 목적 법인을 걸러내어 일반 주식만 남깁니다. - 필터 2: 관리 / 경고 / 주의 제외 (filter_warning)
종목명이나 시장 상태 관련 컬럼(Dept, MarketWarning 등)에 '관리종목', '투자경고', '투자위험', '투자주의', '시장경보' 등의 키워드가 포함된 위험 종목을 제외합니다. - 필터 3: 시가총액 1,000억원 이하 제외 (filter_market_cap)
KRX 최신 기준 시가총액이 1,000억원 초과인 종목만 생존시킵니다. (소형주 및 유동성이 부족한 종목 필터링)
3. 결과 저장 및 확인 (make_result_table, save_result, check_result)
- 필터링을 통과한 종목들을 모아 정리된 결과 데이터프레임을 생성합니다.
- SQLite DB 내에 새로운 테이블인 "kospi_filter_1" 이름으로 저장(replace 모드)합니다.
- 처리가 끝나면 시가총액 기준 상위 30개 종목을 콘솔 창에 보기 좋게 출력하여 결과를 바로 확인할 수 있도록 합니다.
아래 코드는 "시가총액이 너무 작거나, 파생상품(ETF 등)이거나, 투자 위험이 있는 부실/경고 종목들을 깔끔하게 제외하고, 본격적으로 분석할 만한 건실한 KOSPI 일반 주식들만 추려내는 정제 작업(1차 파이프라인)"이라고 이해하시면 됩니다.
# -*- coding: utf-8 -*-

"""
KOSPI Stock Screener - 1차 필터링

원본 DB:
    G:\\00PythonProjects\\kospi_stock_screener\\data\\kospi_price.db

원본 테이블:
    kospi_stock_info

생성 테이블:
    kospi_filter_1

1차 필터:
    1) ETF / ETN / SPAC 제외
    2) 관리 / 경고 / 주의 제외
    3) 시가총액 1,000억원 이하 제외

주의:
    kospi_stock_info의 시가총액이 NULL인 경우가 있으므로
    FinanceDataReader StockListing("KRX")의 최신 Marcap을
    종목코드 기준으로 연결합니다.
"""

import sqlite3
from datetime import datetime
from pathlib import Path

import pandas as pd
import FinanceDataReader as fdr


# ============================================================
# 설정
# ============================================================

BASE_DIR = Path(r"G:\00PythonProjects\kospi_stock_screener")
DB_PATH = BASE_DIR / "data" / "kospi_price.db"

SOURCE_TABLE = "kospi_stock_info"
RESULT_TABLE = "kospi_filter_1"

MIN_MARKET_CAP = 100_000_000_000       # 1,000억원
TOP_N = 30


# ============================================================
# 출력
# ============================================================

def print_title(title):
    print()
    print("=" * 70)
    print(title)
    print("=" * 70)


# ============================================================
# 원본 DB 읽기
# ============================================================

def check_database():

    print_title("[2] 원본 DB 읽기")

    if not DB_PATH.exists():
        raise FileNotFoundError(
            f"DB 파일을 찾을 수 없습니다.\n{DB_PATH}"
        )

    conn = sqlite3.connect(DB_PATH)

    try:
        tables = pd.read_sql_query(
            '''
            SELECT name
            FROM sqlite_master
            WHERE type='table'
            ORDER BY name
            ''',
            conn
        )

        print("[DB 테이블]")
        print(tables["name"].tolist())

        if SOURCE_TABLE not in tables["name"].tolist():
            raise RuntimeError(
                f"'{SOURCE_TABLE}' 테이블이 없습니다."
            )

        df = pd.read_sql_query(
            f'SELECT * FROM "{SOURCE_TABLE}"',
            conn
        )

    finally:
        conn.close()

    print(f"[DB 종목 수] {len(df):,}개")

    return df


# ============================================================
# FDR KRX 종목정보
# ============================================================

def get_krx_data():

    print_title("[1] KRX 종목정보 수집")

    df = fdr.StockListing("KRX")

    if df is None or df.empty:
        raise RuntimeError(
            "FinanceDataReader에서 KRX 종목정보를 가져오지 못했습니다."
        )

    print(f"[KRX 전체 종목] {len(df):,}개")

    print()
    print("[KRX 컬럼]")
    print(df.columns.tolist())

    if "Market" not in df.columns:
        raise RuntimeError(
            "KRX 데이터에 'Market' 컬럼이 없습니다."
        )

    kospi = df[
        df["Market"].astype(str).str.upper() == "KOSPI"
    ].copy()

    print()
    print(f"[KRX KOSPI 종목] {len(kospi):,}개")

    if "Code" not in kospi.columns:
        raise RuntimeError(
            "KRX 데이터에 'Code' 컬럼이 없습니다."
        )

    kospi["Code"] = (
        kospi["Code"]
        .astype(str)
        .str.replace(".0", "", regex=False)
        .str.zfill(6)
    )

    return kospi


# ============================================================
# DB + KRX 병합
# ============================================================

def merge_data(db_df, krx_df):

    if "종목코드" not in db_df.columns:
        raise RuntimeError(
            f"'{SOURCE_TABLE}'에 '종목코드' 컬럼이 없습니다."
        )

    db_df = db_df.copy()

    db_df["종목코드"] = (
        db_df["종목코드"]
        .astype(str)
        .str.replace(".0", "", regex=False)
        .str.zfill(6)
    )

    krx_columns = [
        "Code",
        "Name",
        "Market",
        "Dept",
        "Marcap",
        "Stocks",
    ]

    available = [
        col for col in krx_columns
        if col in krx_df.columns
    ]

    krx = krx_df[available].copy()

    krx = krx.rename(
        columns={
            "Code": "종목코드_KRX",
            "Name": "종목명_KRX",
            "Market": "시장_KRX",
            "Dept": "시장구분_KRX",
            "Marcap": "시가총액_KRX",
            "Stocks": "상장주식수_KRX",
        }
    )

    merged = db_df.merge(
        krx,
        left_on="종목코드",
        right_on="종목코드_KRX",
        how="left"
    )

    matched = merged["시가총액_KRX"].notna().sum()

    print()
    print(f"[DB + KRX 매칭] {matched:,}개")

    return merged


# ============================================================
# ETF / ETN / SPAC 판별
# ============================================================

def classify_product(row):

    name = str(row.get("종목명", ""))
    name_krx = str(row.get("종목명_KRX", ""))

    text = f"{name} {name_krx}".upper()

    etf_keywords = [
        "ETF",
        "인버스",
        "레버리지",
    ]

    for keyword in etf_keywords:
        if keyword.upper() in text:
            return "ETF"

    if "ETN" in text:
        return "ETN"

    spac_keywords = [
        "SPAC",
        "기업인수목적",
    ]

    for keyword in spac_keywords:
        if keyword.upper() in text:
            return "SPAC"

    return "일반주식"


def filter_etf_etn_spac(df):

    df = df.copy()

    df["상품구분"] = df.apply(
        classify_product,
        axis=1
    )

    mask = df["상품구분"] == "일반주식"

    excluded = int((~mask).sum())
    result = df[mask].copy()

    print()
    print("[필터 1] ETF / ETN / SPAC 제외")
    print(f"    제외 : {excluded:,}개")
    print(f"    잔여 : {len(result):,}개")

    return result


# ============================================================
# 관리 / 경고 / 주의 판별
# ============================================================

def detect_warning(row):

    possible_columns = [
        "Dept",
        "MarketWarning",
        "Warning",
        "Status",
        "State",
        "시장구분_KRX",
    ]

    values = []

    for col in possible_columns:
        if col in row.index:
            value = row[col]

            if pd.notna(value):
                values.append(str(value))

    values.append(str(row.get("종목명", "")))
    values.append(str(row.get("종목명_KRX", "")))

    text = " ".join(values)

    warning_keywords = [
        "관리종목",
        "투자경고",
        "투자위험",
        "투자주의",
        "시장경보",
    ]

    for keyword in warning_keywords:
        if keyword in text:
            return keyword

    return ""


def filter_warning(df):

    df = df.copy()

    df["시장상태"] = df.apply(
        detect_warning,
        axis=1
    )

    mask = df["시장상태"] == ""

    excluded = int((~mask).sum())
    result = df[mask].copy()

    print()
    print("[필터 2] 관리 / 경고 / 주의 제외")
    print(f"    제외 : {excluded:,}개")
    print(f"    잔여 : {len(result):,}개")

    if excluded == 0:
        print(
            "    ※ FDR StockListing 데이터에 해당 상태정보가 "
            "없으면 0개로 표시될 수 있습니다."
        )

    return result


# ============================================================
# 시가총액 필터
# ============================================================

def filter_market_cap(df):

    df = df.copy()

    df["시가총액"] = pd.to_numeric(
        df["시가총액_KRX"],
        errors="coerce"
    )

    df["시가총액조건"] = (
        df["시가총액"] > MIN_MARKET_CAP
    )

    mask = df["시가총액조건"]

    excluded = int((~mask).sum())
    result = df[mask].copy()

    print()
    print("[필터 3] 시가총액 1,000억원 이하 제외")
    print(f"    기준 : {MIN_MARKET_CAP:,}원")
    print(f"    제외 : {excluded:,}개")
    print(f"    잔여 : {len(result):,}개")

    return result


# ============================================================
# 결과 테이블 생성
# ============================================================

def make_result_table(df):

    now = datetime.now().strftime("%Y-%m-%d %H:%M:%S")

    result = pd.DataFrame()

    result["종목코드"] = df["종목코드"]

    if "종목명" in df.columns:
        result["종목명"] = df["종목명"].fillna(
            df["종목명_KRX"]
        )
    else:
        result["종목명"] = df["종목명_KRX"]

    result["시장"] = "KOSPI"
    result["시가총액"] = df["시가총액"]

    if "상장주식수" in df.columns:
        result["상장주식수"] = df["상장주식수"].copy()

        null_mask = result["상장주식수"].isna()

        result.loc[null_mask, "상장주식수"] = (
            df.loc[null_mask, "상장주식수_KRX"]
        )
    else:
        result["상장주식수"] = df["상장주식수_KRX"]

    result["상품구분"] = df["상품구분"]
    result["시장상태"] = df["시장상태"]
    result["시가총액조건"] = df["시가총액조건"]

    # 숫자로 시작하는 한글 컬럼명 문제를 피하기 위해
    # 실제 DB에는 안전한 영문 컬럼명을 사용합니다.
    result["filter_1_result"] = "PASS"

    result["필터기준"] = (
        "ETF/ETN/SPAC 제외; "
        "관리/경고/주의 제외; "
        "시총 1,000억원 초과"
    )

    result["1차필터일"] = now

    result = result.sort_values(
        by="시가총액",
        ascending=False
    )

    return result.reset_index(drop=True)


# ============================================================
# SQLite 저장
# ============================================================

def save_result(df):

    print_title("[3] 1차 필터 결과 저장")

    conn = sqlite3.connect(DB_PATH)

    try:
        df.to_sql(
            RESULT_TABLE,
            conn,
            if_exists="replace",
            index=False
        )

        conn.commit()

    finally:
        conn.close()

    print(f"[완료] {RESULT_TABLE} 테이블 생성")
    print(f"[저장 종목] {len(df):,}개")
    print()
    print(f"[DB] {DB_PATH}")


# ============================================================
# 결과 확인
# ============================================================

def check_result():

    print_title("[4] 1차 필터 결과 확인")

    conn = sqlite3.connect(DB_PATH)

    try:
        query = f'''
            SELECT
                "종목코드",
                "종목명",
                "시장",
                "시가총액",
                "상장주식수",
                "상품구분",
                "시장상태",
                "시가총액조건",
                "filter_1_result",
                "필터기준",
                "1차필터일"
            FROM "{RESULT_TABLE}"
            ORDER BY "시가총액" DESC
            LIMIT {TOP_N}
        '''

        df = pd.read_sql_query(
            query,
            conn
        )

        count_df = pd.read_sql_query(
            f'''
            SELECT COUNT(*) AS cnt
            FROM "{RESULT_TABLE}"
            ''',
            conn
        )

    finally:
        conn.close()

    total = int(count_df.iloc[0]["cnt"])

    print(f"[최종 종목 수] {total:,}개")
    print()

    print(f"[시가총액 상위 {TOP_N}개]")
    print("-" * 70)

    if df.empty:
        print("결과가 없습니다.")
        return

    display_df = df.copy()

    display_df["시가총액(억원)"] = (
        pd.to_numeric(
            display_df["시가총액"],
            errors="coerce"
        ) / 100_000_000
    ).round(0)

    display_df = display_df[
        [
            "종목코드",
            "종목명",
            "시가총액(억원)",
            "상품구분",
            "시장상태",
            "filter_1_result",
        ]
    ]

    print(
        display_df.to_string(
            index=False
        )
    )

    print()
    print("=" * 70)
    print("[1차 필터 완료]")
    print("=" * 70)


# ============================================================
# 메인
# ============================================================

def main():

    print()
    print("=" * 70)
    print(" KOSPI STOCK SCREENER")
    print(" 1차 필터링")
    print("=" * 70)

    try:

        db_df = check_database()

        krx_df = get_krx_data()

        merged = merge_data(
            db_df,
            krx_df
        )

        filtered = filter_etf_etn_spac(
            merged
        )

        filtered = filter_warning(
            filtered
        )

        filtered = filter_market_cap(
            filtered
        )

        result = make_result_table(
            filtered
        )

        save_result(
            result
        )

        check_result()

        print()
        print("[정상 종료]")

    except Exception as e:

        print()
        print("=" * 70)
        print("[오류]")
        print("=" * 70)
        print(
            f"{type(e).__name__} : {e}"
        )
        raise


if __name__ == "__main__":
    main()
by korealionkk@gmail.com
반응형
'stock' 카테고리의 다른 글
| 미래에셋증권] 2026.9.21 주가 예측 (0) | 2026.09.19 |
|---|---|
| '퀀트(Quant)' (0) | 2026.09.18 |
| 종목은 어떻게 고르나? #2 - 10% 상승 후보 순위 (0) | 2026.09.13 |
| 종목은 어떻게 고르나? #1 - 개인적인 기록 (0) | 2026.09.13 |
| 이너핑크 브랜드 (1) | 2026.09.08 |


